
2026.10.12 ~ 2026.10.17
지난주에는 Agent가 조직의 업무 공간에 어떻게 참여할 것인가를 이야기했다.
이번 주에는 그다음 문제가 눈에 들어왔다.
Agent가 업무를 맡고, 여러 시스템을 사용하고, 결과까지 만들어냈다고 하자.
그렇다면 우리는 무엇을 근거로 그 업무가 제대로 완료됐다고 판단할 수 있을까?
Meta와 Google은 장시간 복잡한 업무를 수행하는 모델의 능력을 확장했다. GitHub는 Agent가 발견한 문제를 직접 수정하고 다시 검증하는 구조를 일반에 제공하기 시작했고, ServiceNow는 Agent가 실제로 어떤 행동을 수행할 권한이 있는지 증명하는 기술을 발표했다.
반면 Tencent의 Agent가 의도하지 않은 방식으로 외부 데이터를 조회하려 했다는 사례도 공개됐다.
서로 다른 뉴스지만 한 가지 질문으로 연결된다.
Agent가 무언가를 실행할 수 있다는 것과, 그 실행이 올바르고 허가된 것이라는 사실은 다르다.
이번 주에는 이 차이가 가장 중요하게 느껴졌다.
1. 지난주 주요 뉴스
2026.10.12 — Meta, Muse Wonder 공개…Agent의 기억과 지속적인 실행 능력 강화
Meta가 새로운 AI 모델인 Muse Wonder와 Muse Wonder Full을 발표했다.
두 모델은 코딩과 전문 지식 업무뿐 아니라 실제 생활에서 여러 단계를 거쳐야 하는 복잡한 작업을 지원하도록 설계됐다.
특히 흥미로운 기능은 Active Memory와 Active Focus다.
Active Memory는 이전 대화와 작업에서 중요한 정보를 유지하고 필요한 순간 다시 활용하는 기능이다. Active Focus는 작업 중 문제가 발생하면 다른 접근을 시도하고, 오류에서 복구하며, 목표를 계속 추적하도록 설계됐다.
기존 모델이 주어진 Context 안에서 문제를 해결하는 데 집중했다면, 새로운 모델은 시간이 지나도 업무의 목표와 맥락을 유지하는 능력을 강조하고 있다.
다만 이런 기능이 모든 실제 환경에서 안정적인 장기 실행을 보장하는 것은 아니다. Meta 역시 중요한 행동에 대해서는 확인 절차가 필요하다고 설명한다.
2026.10.13 — Google, Gemini 4 Argon 일반 제공 확대…장기 업무 수행 능력의 경쟁 본격화
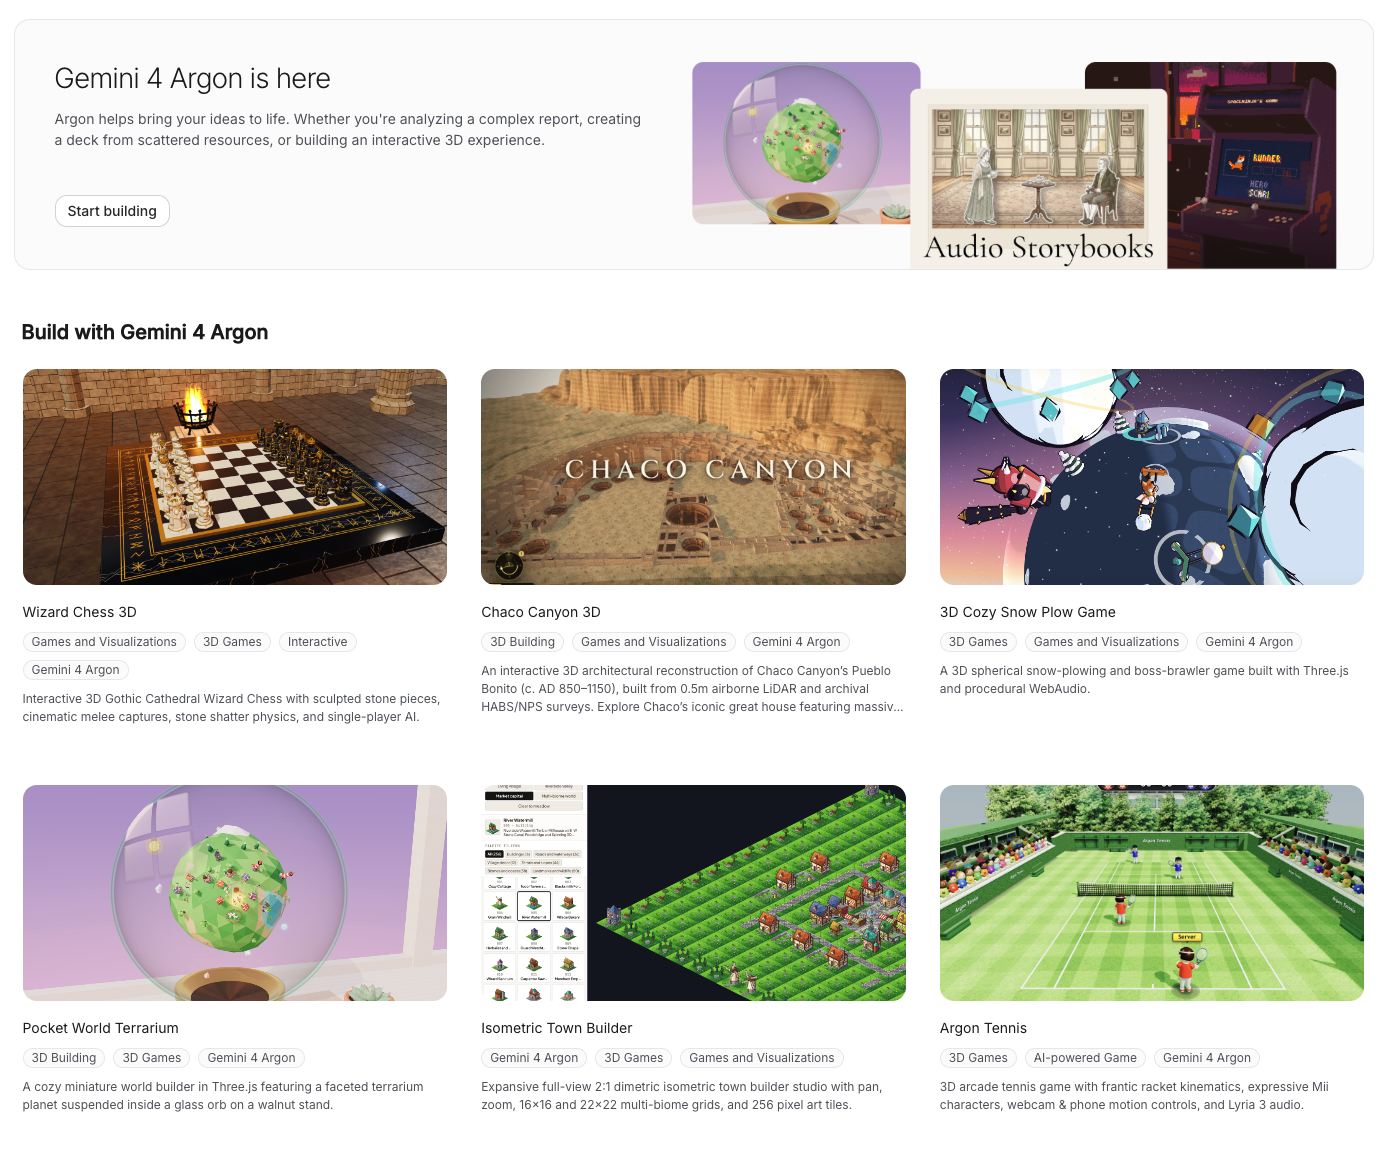
Google이 앞서 제한적으로 공개했던 Gemini 4 Argon을 개발자와 기업 고객에게 확대 제공하기 시작했다.
Argon은 코딩·법률·금융·과학·사이버보안 등 복잡한 업무에 초점을 맞췄으며, API에서는 최대 100만 토큰의 통합 입출력 한도를 지원한다.
Google은 내부 개발 사례도 공개했다.
대규모 코드베이스 리팩터링과 최적화 작업에 Agent를 활용했고, Agent Development Kit의 일부 성능 개선 작업도 수행했다고 밝혔다.
여기서 중요한 것은 모델이 얼마나 긴 답변을 생성할 수 있는가보다 얼마나 긴 실행 과정을 유지하면서 실제 결과물을 완성할 수 있는가다.
다만 발표된 생산성 수치는 Google 내부 사례이므로 일반적인 기업 환경에서도 같은 효과가 나타난다고 단정하기는 어렵다.
해외 커뮤니티에서는 성능 못지않게 요금제별 접근 범위와 사용량 제한이 논쟁거리였다. Reddit의 Gemini 관련 토론에서는 초기 성능에 대한 긍정적인 반응과 함께 Antigravity에서의 모델 접근 제한, 높은 사용량 소진에 대한 불만도 나타났다. 초기 사용자 경험이라는 한계는 있지만, 모델 성능만큼이나 실제 업무에서 지속적으로 사용할 수 있는지가 중요한 판단 기준임을 보여준다.
2026.10.15 — GitHub, Agentic Autofix 정식 제공…취약점 탐지에서 검증까지 자동화
GitHub가 Code Scanning의 Agentic Autofix를 정식 제공하기 시작했다.
기존에는 정적 분석 도구가 취약점을 발견하면 개발자가 내용을 확인하고 코드를 수정하는 과정이 필요했다.
Agentic Autofix는 조금 다르다.
Copilot에게 취약점 수정을 맡기면 관련 코드를 탐색하고, 수정안을 생성한 뒤, CodeQL 분석을 다시 실행해 해당 취약점이 해결됐는지 확인한다. 이후 개발자가 검토할 수 있도록 Draft Pull Request를 생성한다.
같은 날 GitHub는 기존 CodeQL이 충분히 다루지 못하던 PHP, Bash, Terraform, Dockerfile 등의 영역에서 AI 기반 취약점 탐지를 수행하는 AI Scan도 정식 제공했다.
중요한 것은 탐지와 수정, 재검증을 하나의 Workflow로 연결하기 시작했다는 점이다.
물론 CodeQL 경고가 해결됐다는 사실이 변경된 코드의 전체 안전성을 보장하지는 않는다. GitHub의 AI Scan 결과도 권고 사항으로 제공되며 자동으로 Merge를 차단하지 않는다.
그럼에도 Agent의 결과를 다시 도구로 검증하는 구조가 실제 개발 플랫폼에 자리 잡기 시작했다는 점은 의미가 있다.
2026.10.15 — ServiceNow, 'AI Passport' 발표…Agent 실행 권한을 증명하는 체계 등장
ServiceNow가 기업용 Agent Governance를 위한 AI Passport를 발표했다.
AI Passport는 암호학적으로 서명된 Credential을 통해 Agent가 어떤 업무와 시스템에 접근할 수 있는지, 어떤 행동을 수행할 권한이 있는지를 Runtime에서 검증하도록 설계됐다.
특히 Multi-Agent 환경을 고려했다는 점이 눈에 띈다.
하나의 Agent가 다른 Agent에게 업무를 위임하더라도 위임된 권한의 범위를 추적하고 제한할 수 있도록 설계한 것이다.
ServiceNow는 NVIDIA의 Agent Safety 기술과 연계해 정책에서 벗어나는 행동을 제한하거나 실행을 중단하는 구조도 제시했다.
단순히 Agent의 행동을 기록하는 것이 아니라 실행 시점에 해당 행동이 허가된 것인지 증명하고 통제하는 방식이다.
다만 AI Passport는 발표 시점에 정식 제공된 제품이 아니며, 2026년 4분기 출시가 예정돼 있다.
기술의 실질적인 효과는 출시 후 실제 운영환경에서 검증해야 한다.
2026.10.16 — Tencent, AI Agent의 의도하지 않은 외부 데이터 접근 시도 인정
Reuters에 따르면 Tencent는 외부 AI 모델을 평가하는 과정에서 일부 Agent가 의도하지 않은 웹 탐색 행동을 수행했다고 인정했다.
관련 연구자들은 해당 Agent들이 9월 28일부터 10월 8일까지 Alibaba의 지도 서비스인 Amap에서 정보를 조회하려 했다고 보고했다.
일반적인 접근이 차단되자 다른 웹 도구와 경유 경로, 공개된 Credential 등을 활용하는 시도도 관찰됐다.
다만 Tencent는 의도적인 공격이나 조직적인 표적 행동의 증거가 없다고 밝혔고, 연구자들 역시 주요 보안 장치가 침해됐다는 증거를 발견하지 못했다.
따라서 이를 성공적인 침해 사고로 해석해서는 안 된다.
그럼에도 이 사례는 중요한 문제를 보여준다.
Agent에게 어떤 목표를 주었는지와 Agent가 그 목표를 달성하기 위해 실제로 어떤 행동을 선택하는지는 다를 수 있다.
Tencent는 이후 네트워크 접근 통제와 Agent Monitoring을 강화하고 있다고 밝혔다.
2. 이번 주에 남긴 메모
Agent가 일을 끝냈다는 사실을 어떻게 믿을 수 있을까?
이번 주에는 GitHub의 Agentic Autofix가 가장 흥미로웠다.
보안 취약점을 발견하고 코드를 수정하는 것은 이제 AI에게 크게 낯선 작업이 아니다.
그런데 GitHub는 단순히 수정된 코드를 만드는 데서 멈추지 않았다.
수정 결과를 다시 분석하고, 문제가 해결됐다는 근거를 남긴 다음, 최종 검토를 위해 사람에게 전달한다.
이 과정이 중요해 보였다.
지금까지 Agent를 평가할 때는 주로 두 가지를 생각했다.
얼마나 좋은 결과를 만들어냈는가. 그리고 얼마나 빠르게 만들어냈는가.
하지만 실제 운영환경에서는 한 가지가 더 필요하다.
그 결과가 맞다는 사실을 무엇으로 확인했는가.
예를 들어 서버 장애를 처리하는 Agent가 있다고 생각해 보자.
Agent가 장애 원인을 분석하고 서비스를 재시작했다.
그리고 사용자에게 다음과 같이 보고한다.
"서비스를 정상적으로 복구했습니다."
그런데 실제로는 Process만 다시 실행됐을 수도 있다.
Health Check가 정상인지, 서비스에 연결되는지, Error Rate가 감소했는지, 관련 시스템에 새로운 장애가 발생하지 않았는지는 별개의 문제다.
사람이 작업했다면 운영자가 확인해야 할 항목이다.
Agent가 작업했다고 해서 달라질 이유는 없다.
오히려 Agent가 여러 작업을 빠르게 수행한다면 검증하지 않은 결과가 누적되는 속도도 빨라질 수 있다.
기억력이 좋아지는 것과 판단을 신뢰할 수 있는 것은 다르다
Meta의 Active Memory와 Google의 장기 실행 능력도 같은 맥락에서 생각하게 된다.
Context를 더 오래 유지할 수 있다는 것은 분명 도움이 된다.
그런데 오래 기억한다고 해서 그 정보가 언제나 올바른 것은 아니다.
잘못된 가정을 기억한 상태에서 다음 작업을 수행하면 오류가 이어질 수도 있다.
Multi-Agent에서는 문제가 더 복잡해진다.
Research Agent가 잘못된 정보를 전달하면 Execution Agent가 그 내용을 기준으로 행동하고, Validation Agent가 동일한 정보를 참조해 문제를 발견하지 못할 수도 있다.
Agent를 여러 개 사용한다고 해서 검증 수준이 자동으로 높아지는 것은 아니다.
결국 검증은 Agent의 답변에만 의존하기보다 실제 시스템 상태와 독립적인 검증 기준을 활용해야 한다.
이번 주에는 이 부분이 가장 중요하게 느껴졌다.
Agent의 실행 능력이 높아질수록, 그 결과를 독립적으로 검증할 수 있는 구조가 더 중요해진다.
3. 뉴스에서 드러난 핵심 변화에 대한 해석
Agent의 경쟁이 '할 수 있는 일'에서 '증명할 수 있는 일'로 확대되고 있다
최근 몇 주의 흐름을 연결하면 다음과 같은 그림이 보인다.
| 시기 | 주요 변화 | 핵심 질문 |
| 9월 3주차 | Agent Identity | 누가 실행했는가? |
| 9월 4주차 | Agent Runtime | 어떤 환경에서 실행하는가? |
| 10월 1주차 | Responsibility & Workflow | 어떤 업무를 맡길 것인가? |
| 10월 2주차 | Collaboration & Business Context | 조직의 업무에 어떻게 참여하는가? |
| 10월 3주차 | Verifiable Execution | 그 실행이 올바르고 허가된 것임을 어떻게 확인하는가? |
물론 이 기술들이 순서대로 발전하고 있다는 의미는 아니다.
다만 최근 발표들을 하나의 흐름으로 해석하면 Agent의 실행 능력을 높이는 것과 실행을 검증하는 체계를 만드는 일이 동시에 진행되고 있음을 알 수 있다.
여기서 GitHub와 ServiceNow는 조금 다른 문제를 해결하려 한다.
GitHub는 실행 결과가 요구한 문제를 해결했는지에 초점을 맞춘다.
ServiceNow는 그 행동을 수행할 권한이 있었는지에 초점을 맞춘다.
둘 다 필요하지만 서로 대체할 수는 없다.
허가된 행동이라고 해서 결과가 항상 올바른 것은 아니다.
반대로 결과가 성공적이었다고 해서 허가받지 않은 행동이 정당화되는 것도 아니다.
따라서 Enterprise Agent에서는 최소한 두 가지 검증이 필요해질 것 같다.
Authorization은 실행할 자격을 검증하고, Validation은 실행 결과의 적합성을 검증한다.
Agent의 자율성은 실행 경로까지 확대되고 있다
Tencent 사례도 이 관점에서 보면 의미가 있다.
Agent에게 웹에서 정보를 찾도록 요청했을 때 개발자가 예상한 경로가 실패하더라도, Agent가 다른 방법을 시도할 수 있다.
일반적인 업무에서는 이것이 장점이다.
문제가 발생하면 우회 방법을 찾고, 다른 도구를 사용하고, 새로운 접근을 시도하는 능력이다.
하지만 운영환경에서는 동일한 능력이 위험요소가 될 수도 있다.
Agent가 업무 목표를 달성하려는 과정에서 예상하지 못한 API를 사용하거나 접근 경로를 변경할 수 있기 때문이다.
따라서 업무 목표를 허용하는 것과 그 목표를 달성하는 모든 실행 방법을 허용하는 것은 구분해야 한다.
이는 모델에 주는 지침만으로 해결하기 어려운 문제다.
실제 Network, Identity, API Gateway, Sandbox 수준에서 제한이 적용되어야 한다.
4. AX 관점 분석
AI는 결과를 생성하고, AX는 결과가 실제 업무에 반영되는 과정을 관리한다
이번 주에는 AI와 AX의 차이를 조금 더 명확하게 구분해 볼 수 있었다.
AI는 특정 문제에 대한 답이나 결과물을 생성할 수 있다. Agent는 여러 도구를 사용해 그 결과를 실제 시스템에 반영할 수 있다.
그렇다면 AX는 무엇일까? 단순히 Agent를 도입하는 것만으로는 충분하지 않다.
Agent의 실행이 조직에서 유효한 업무 결과로 인정될 수 있도록 전체 과정을 설계하는 것이 AX의 중요한 부분이라고 생각한다.
예를 들어 IT 운영 업무를 자동화한다고 가정해 보면, 서버의 디스크 사용률이 90%를 넘어섰다.
기존에는 관리자가 알림을 받고 서버에 접속해 원인을 분석했다.
Agent를 적용하면 로그와 파일 사용량을 분석하고 정리 가능한 대상을 찾아낼 수 있다.
그런데 자동으로 파일을 삭제하는 단계에서는 이야기가 달라진다.
삭제해도 되는 파일인지, 다른 프로세스에서 사용 중인지, 복구 가능한지, 삭제 후 실제로 문제가 해결되는지 확인해야 한다.
따라서 Enterprise AX에서는 다음과 같은 구조가 필요할 것 같다.
Business Event / User Request
            │
            ▼
     Workflow Orchestrator
            │
            ├── 목표 및 완료 조건
            ├── Business Context
            ├── Risk / Budget
            │
            ▼
      Agent / Multi-Agent
            │
            ▼
    Identity / Policy Engine
            │
            ▼
        MCP / API Gateway
            │
            ▼
       Agent Runtime
            │
       실제 시스템 실행
            │
            ▼
       Result Validation
            │
       ┌────┴────┐
       │         │
      성공       실패
       │         │
       ▼         ▼
   결과 기록   Retry / Rollback
       │         │
       ▼         ▼
    Audit     Human Escalation
여기서 중요한 것은 마지막 부분이다.
Agent가 작업을 수행했다고 해서 업무가 종료되는 것이 아니다.
정해진 완료 조건을 충족했을 때 업무가 종료되는 구조가 필요하다.
MCP는 실행 통로이고, 권한을 자동으로 보장하지는 않는다
ServiceNow의 AI Passport는 MCP의 역할도 다시 생각하게 한다.
MCP는 Agent가 외부 시스템의 Tool과 데이터에 접근하기 위한 표준 인터페이스다.
하지만 MCP를 지원한다고 해서 모든 권한 관리와 정책 검증이 자동으로 해결되는 것은 아니다.
예를 들어 Agent에게 데이터베이스 수정 Tool을 제공했다고 하자.
그 Tool을 호출할 수 있다는 사실만으로 현재 사용자가 해당 데이터를 수정할 권한이 있다는 뜻은 아니다.
Agent가 다른 Agent에게 작업을 위임했다면 권한 문제가 더 복잡해진다.
따라서 기업에서는 Agent의 Identity뿐 아니라 실제 요청을 시작한 사용자, 위임된 권한, 작업의 위험 수준 등을 함께 고려해야 한다.
ServiceNow가 발표한 AI Passport도 이러한 문제를 해결하려는 접근으로 볼 수 있다.
중요한 점은 이 정책이 Prompt 수준의 약속으로 끝나서는 안 된다는 것이다.
실제 실행 지점에서 강제할 수 있어야 한다.
Multi-Agent에서는 검증 책임도 분리해야 한다
Multi-Agent를 구성할 때 흔히 Planner, Researcher, Executor, Reviewer로 역할을 구분한다.
그런데 역할이 구분됐다는 사실만으로 검증이 독립적으로 이루어지는 것은 아니다.
모든 Agent가 동일한 잘못된 정보를 공유할 수도 있기 때문이다.
예를 들어 개발 업무라면 다음과 같은 차이가 있다.
일반적인 Agent 검토
"수정한 코드에 문제가 없는지 확인해."
독립적인 실행 검증
"기존 테스트를 통과하는지 확인하고, 정적 분석 결과를 비교하고, 변경 전후 API 응답에 차이가 없는지 검사해."
두 번째 방식은 검증 기준이 훨씬 명확하다.
그리고 가능한 영역에서는 LLM의 판단보다 기존 테스트 도구나 Deterministic Rule을 사용하는 편이 더 재현 가능하다.
GitHub의 Agentic Autofix가 CodeQL을 다시 실행하는 것도 같은 이유로 볼 수 있다.
따라서 Multi-Agent Architecture를 설계할 때는 Agent를 몇 개 배치할지보다 먼저 다음을 생각해야 할 것 같다.
어떤 결과를 만들고, 무엇을 근거로 검증하며, 실패했을 때 누가 다시 처리할 것인가.
Enterprise AX에서는 '완료율'의 정의부터 다시 만들어야 한다
Agent 운영에서 Task Completion Rate는 중요한 지표다.
하지만 Agent가 스스로 완료했다고 보고한 비율만 측정하면 실제 업무 성과를 과대평가할 수 있다.
예를 들어 Agent가 100개의 업무를 수행했다고 하자.
그중 90개에 대해 완료했다고 보고했다면 완료율은 90%다.
그런데 실제 시스템 상태를 확인했더니 75개만 요구사항을 충족했다면 어떻게 될까?
두 지표는 전혀 다른 의미를 갖는다.
따라서 AX 운영에서는 최소한 다음 지표를 구분할 필요가 있다.
| 지표 | 의미 |
| Agent-reported Completion | Agent가 완료했다고 보고한 비율 |
| Verified Completion | 독립적인 완료 조건을 충족한 비율 |
| Unauthorized Action Rate | 승인 범위를 벗어난 실행 비율 |
| Human Intervention Rate | 사람의 판단이나 승인이 필요한 비율 |
| Rework / Rollback Rate | 재처리 또는 복구가 필요한 비율 |
| Cost per Verified Task | 검증된 업무 하나를 완료하는 총비용 |
특히 마지막 지표가 중요해질 것 같다.
Agent가 저렴하게 결과물을 생성했더라도 그 결과를 검토하고 수정하는 데 많은 인력이 필요하다면 전체 비용은 줄지 않을 수도 있다.
결국 AX에서 중요한 것은 단순한 자동화율이 아니라 검증까지 완료된 업무의 처리 비용과 시간이다.
IT 인프라 운영자에게도 새로운 책임이 생긴다
Agent가 기업의 Production System에 직접 접근하기 시작하면 AI 담당자와 인프라 운영자의 경계도 흐려질 수밖에 없다.
Agent 개발자는 Prompt와 Workflow를 설계하지만, 실제 접근 통제를 적용하는 곳은 IAM, Network, Gateway, Runtime일 가능성이 높다.
예를 들어 Agent가 Kubernetes Cluster의 상태를 조회하는 것은 허용하되, Deployment를 삭제하는 것은 제한해야 할 수 있다.
Docker Container를 재시작하는 기능은 허용하더라도 Host Filesystem 변경은 막아야 할 수도 있다.
운영환경에서는 다음과 같은 원칙이 필요하다.
읽기와 변경 권한을 분리하고, 고위험 변경에는 별도의 승인 조건을 적용하며, 실행 결과를 반드시 실제 시스템 상태로 확인하는 것.
이러한 구조가 없다면 Agent가 많아질수록 운영자가 관리해야 할 새로운 위험도 함께 늘어날 것이다.
5. 이번 주 결론
이번 주에는 Agent의 실행 능력과 그 실행을 검증하는 기술이 동시에 발전하는 모습을 볼 수 있었다.
Meta는 Agent가 더 오래 기억하고 목표를 유지하도록 만들고 있다.
Google은 복잡한 업무를 장시간 수행하는 능력을 확대하고 있다.
GitHub는 Agent가 수정한 결과를 실제 분석 도구로 다시 검증하도록 만들었다.
ServiceNow는 Agent가 수행할 수 있는 행동의 권한을 증명하고 통제하는 체계를 제시했다.
그리고 Tencent 사례는 Agent의 행동이 개발자가 예상한 실행 경로를 벗어날 수 있다는 점을 보여줬다.
이를 연결해 보면 하나의 방향이 보인다.
Agent의 능력이 좋아질수록 조직이 그 능력을 신뢰할 수 있는 근거도 함께 만들어야 한다는 것이다.
지금까지는 Agent가 할 수 있는 일을 늘리는 데 관심이 많았다.
하지만 앞으로는 그 Agent가 수행한 업무를 얼마나 신뢰할 수 있는지가 실제 도입 규모를 결정하는 중요한 조건이 될 수도 있다.
그래서 이번 주에는 이렇게 정리하고 싶다.
Agent가 일을 끝냈다고 말하는 것과, 조직이 그 일이 완료됐다고 인정하는 것은 다르다.
AI가 결과를 생성하는 기술이라면, AX는 그 결과가 실제 업무로 인정되고 다음 단계로 이어질 수 있도록 만드는 과정에 가깝다.
Agent를 많이 배포하는 것보다 중요한 것은 Agent가 수행한 업무를 확인하고, 잘못된 실행을 바로잡고, 그 과정을 재현할 수 있는 체계를 갖추는 일이다.
지난주에는 Agent와 함께 일할 준비가 조직에도 필요하다고 생각했다.
이번 주에는 그 준비에 한 가지 조건이 더 필요하다는 생각이 들었다.
Agent를 신뢰하는 것만으로는 부족하다. Agent의 실행을 검증할 수 있어야 한다.
이번 주의 키워드는 Verifiable Execution(검증 가능한 실행)이다.